
O HeyDeer tem a maior precisão no ReviewBench
Por que colocamos a precisão em primeiro lugar e como o HeyDeer chega lá
Equipe HeyDeer ·
O ReviewBench é um benchmark aberto de revisão de código com IA, criado pelo GitHub. Ele roda cada revisor em 219 pull requests reais de 187 repositórios e compara o que o revisor aponta com problemas revisados e rotulados por pessoas.
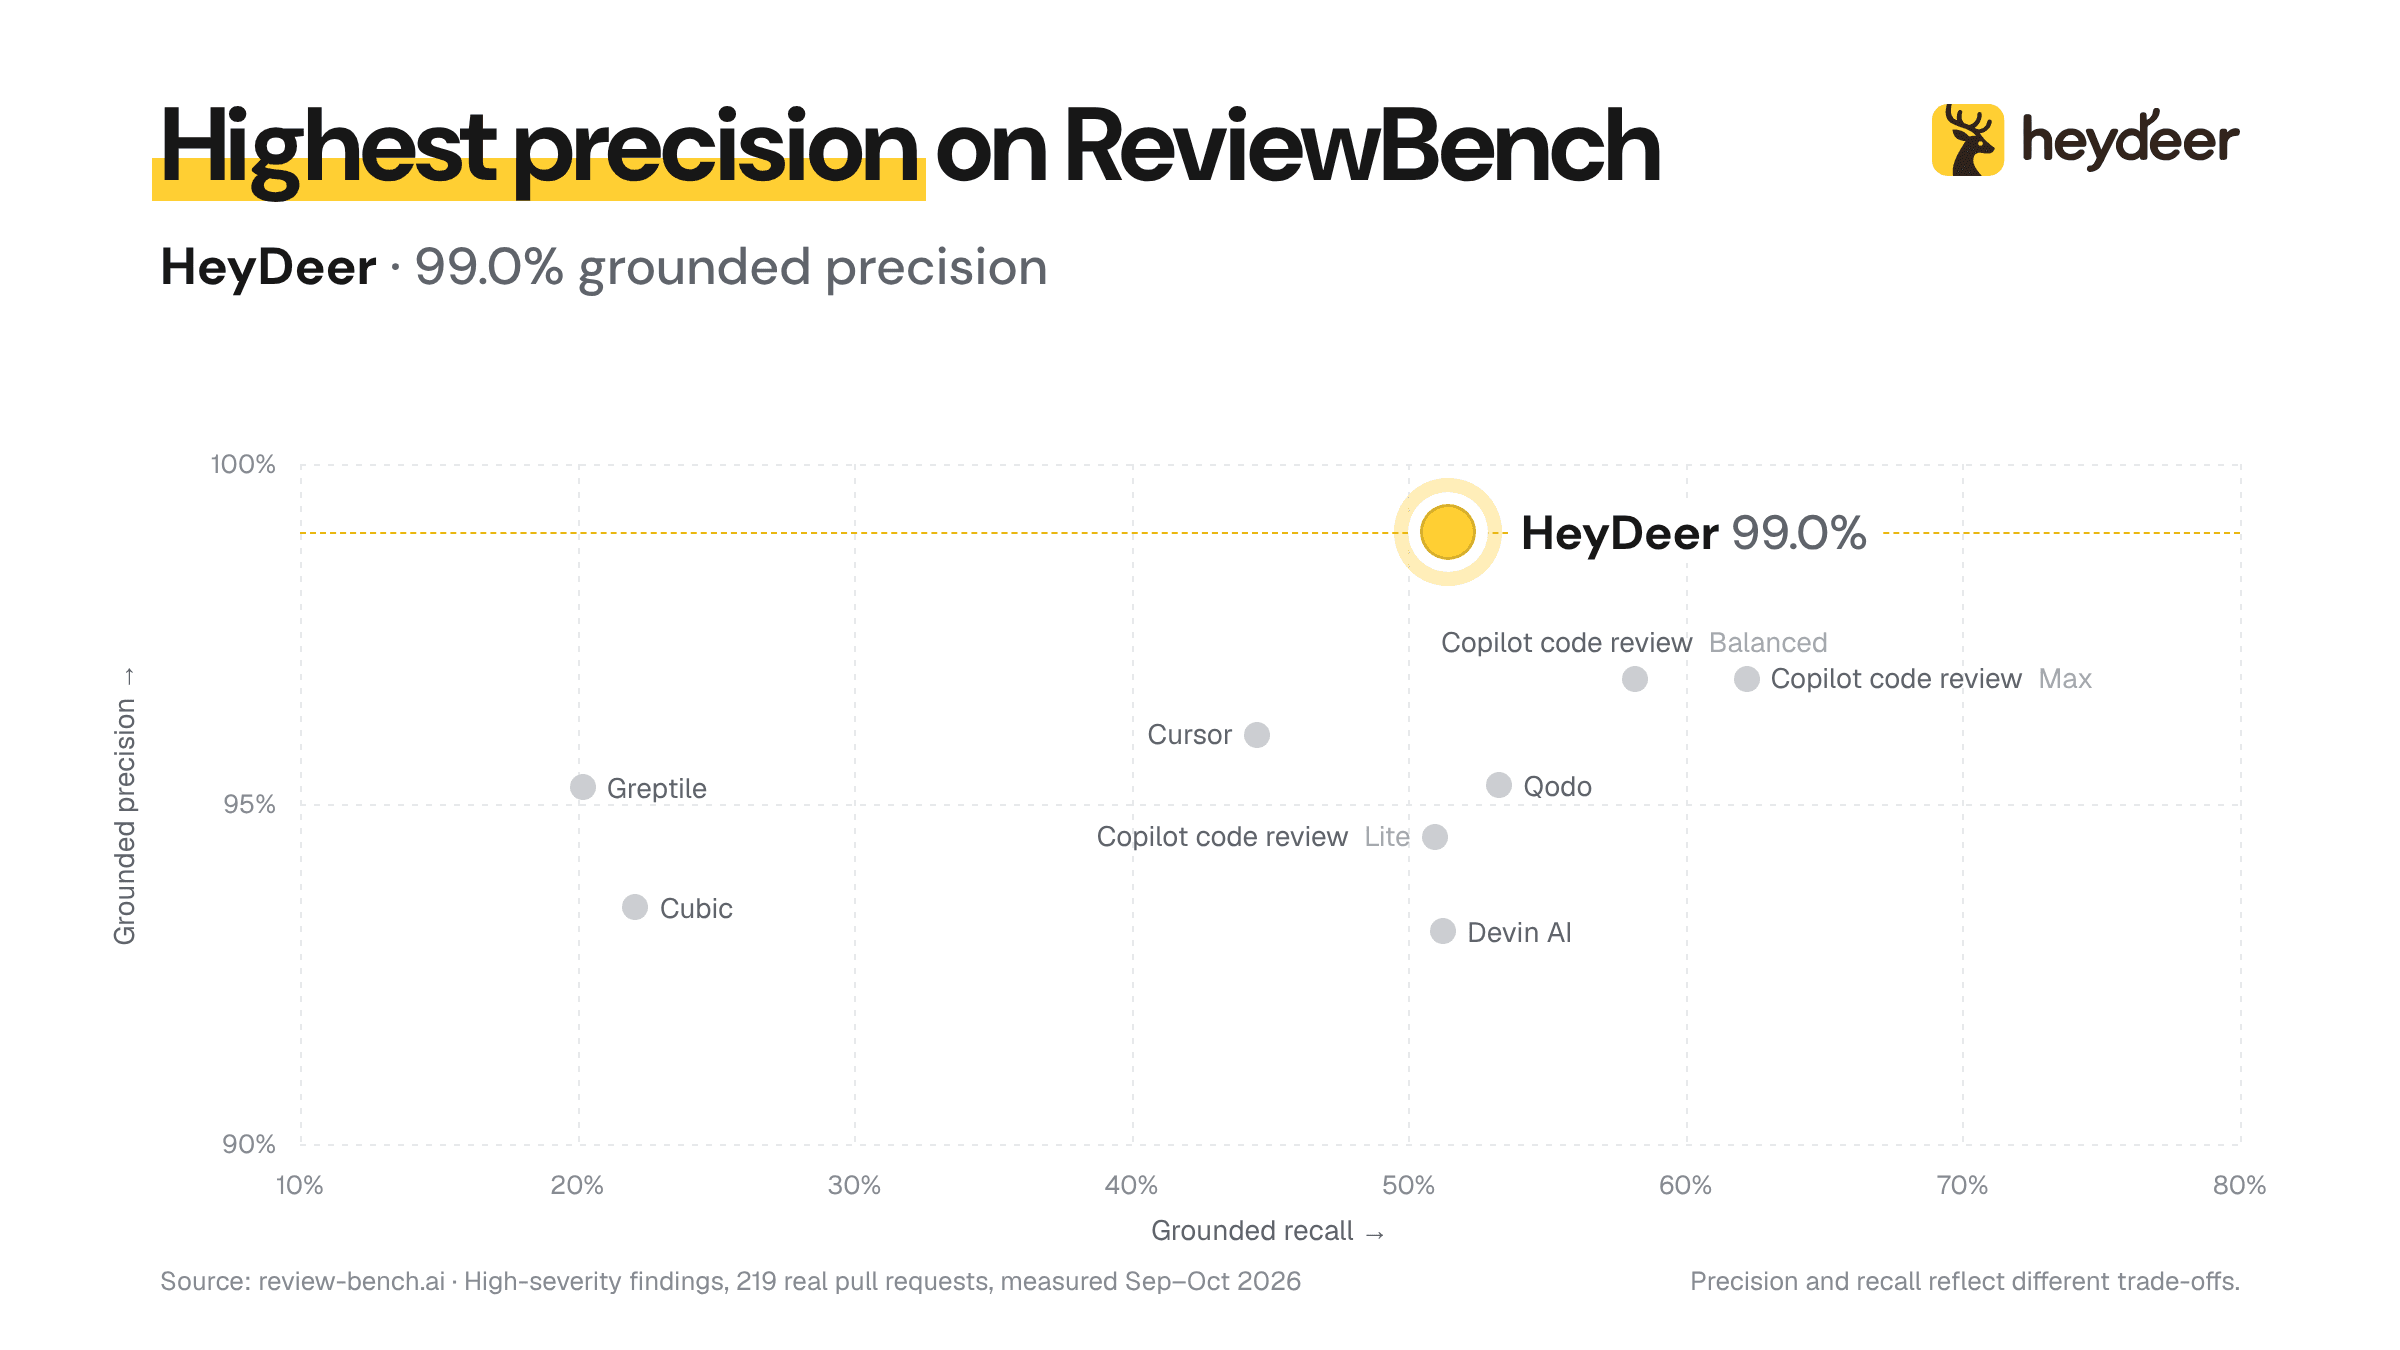
O HeyDeer agora está no ranking. Nos problemas encontrados de gravidade alta, a visualização padrão do ranking, o HeyDeer tem a maior precisão entre todos os revisores: 99,0%. Quase todo problema grave que o HeyDeer apontou era real.
Não foi por acaso. A precisão é o principal objetivo de design do HeyDeer desde o primeiro dia. Neste artigo, explicamos por quê e como chegamos lá.
1. O que os números significam
O ReviewBench apresenta duas pontuações principais (veja a metodologia para mais detalhes):
- Precisão: dos problemas que um revisor aponta e que o benchmark consegue avaliar, quantos são reais.
- Recall: dos problemas conhecidos em um pull request, quantos o revisor encontra.
As duas puxam em direções opostas. Um revisor que aponta tudo encontra mais problemas e mais ruído; um que quase não aponta nada raramente erra e raramente é útil. Na rodada publicada pelo ReviewBench, o recall do HeyDeer em problemas encontrados de gravidade alta foi de 51,4%, na mesma faixa da maioria dos revisores do ranking, enquanto sua precisão foi a mais alta.
2. Por que a precisão importa
Para as pessoas: o ruído esconde os bugs reais
Cada falso positivo custa tempo de alguém: ler o comentário, conferir o código e concluir que ele está errado. O custo maior vem depois. Depois de algumas rodadas de ruído, as pessoas aprendem que os comentários do revisor costumam estar errados e passam a ler por cima, e o único bug real passa junto com o resto.
Uma revisão com oito comentários, seis deles falsos, é pior do que uma com três comentários reais. Um revisor só é útil se as pessoas continuarem lendo o que ele diz.
Para agentes de código: falsos positivos viram código
Cada vez mais equipes passam os comentários de revisão direto para um agente de código. Às vezes um agente contesta, mas pesquisas mostram que ele muitas vezes segue um pedido de correção mesmo depois de perceber que está errado, introduzindo novos erros sem perceber (Jaiswal et al., 2026). Um falso positivo vira uma checagem de null para um valor que não pode ser null, um try/catch em volta de um código que não pode lançar exceção ou uma validação de uma entrada que já foi validada.
Cada um parece inofensivo isoladamente. Juntos, eles incham a base de código, escondem o que o código realmente garante e dão à próxima pessoa, ou ao próximo agente, mais coisa para ler e manter. Quanto mais da revisão você automatiza, mais a precisão importa, porque não sobra ninguém para filtrar o ruído.
3. Como o HeyDeer mantém a precisão alta
Vários modelos revisam e verificam o trabalho uns dos outros
Um único modelo deixa passar problemas e aponta problemas falsos, e várias cópias do mesmo modelo tendem a cometer os mesmos erros. O HeyDeer coloca modelos de fornecedores diferentes para revisar cada mudança e verifica cada possível problema de forma independente antes que ele chegue ao seu pull request. Modelos diferentes têm pontos cegos diferentes, então a verificação cruzada pega boa parte do que qualquer um deles erra.
Concordância, por si só, não é prova: dois modelos podem errar da mesma forma. O que decide se um problema encontrado é publicado é a evidência.
Todo problema encontrado precisa de evidências
Um problema encontrado precisa mostrar como ele acontece: de uma chamada, ação do usuário ou entrada real, passando pelo código alterado, até a consequência. “Isso pode ser null” não basta; o revisor precisa mostrar de onde vem o null. Quando um fato não pode ser confirmado com as evidências disponíveis, o problema encontrado diz isso e aponta esse fato, em vez de apresentar um palpite como certeza.
Ler o código-fonte, não adivinhar
Muitos falsos positivos vêm de supor como algo fora do diff se comporta. Os revisores do HeyDeer verificam em vez de supor:
- Código-fonte das dependências: quando uma afirmação depende do comportamento de uma biblioteca, o revisor lê a implementação real da biblioteca em vez de confiar no que lembra.
- Documentação: os revisores pesquisam a documentação oficial dos frameworks e serviços que o código usa.
- Testes em sandbox: quando ler não basta, um revisor pode testar uma afirmação específica em um sandbox isolado, como a forma como uma função lida com um caso extremo. O código do seu repositório nunca é executado.
4. Recall: encontrar mais sem adicionar ruído
Ter precisão alta é fácil se você ficar calado, então o recall importa tanto quanto. Desde a versão que o ReviewBench mediu, melhoramos o recall do HeyDeer e vamos compartilhar os números quando o ReviewBench publicar uma nova rodada.
A ideia é manter a busca e a filtragem separadas. Os revisores que procuram problemas apontam todo candidato que conseguem sustentar com evidências, mesmo quando parece pequeno ou improvável; depois, a verificação decide o que é real. Como a verificação segura a precisão, a busca pode ir mais fundo e por mais ângulos sem mandar mais ruído para o seu pull request.
Você também decide quanto vê. O escopo do feedback do HeyDeer permite que uma equipe mostre só os problemas encontrados importantes ou todos os confirmados, em um espaço de trabalho ou em um único repositório.
5. Sobre o benchmark
Nenhum benchmark conta a história toda. O ReviewBench é uma prévia de pesquisa; os números acima são da visualização padrão de gravidade alta e mudam com o filtro de gravidade; e uma única pontuação não diz como um revisor se encaixa na sua base de código ou na sua equipe. Achamos que é uma forma justa e aberta de comparar revisores em pull requests reais, e ficamos felizes em ser medidos abertamente.
Experimente nos seus próprios pull requests
O melhor benchmark é o seu próprio código. O HeyDeer tem um plano gratuito, então você pode rodá-lo nos mesmos pull requests que o revisor que você já usa e comparar os resultados por conta própria.