
HeyDeer が ReviewBench で最高の適合率を記録
私たちが適合率を最優先する理由と、HeyDeer がそれを実現する方法
HeyDeer チーム ·
ReviewBench は、GitHub が構築した AI コードレビューのオープンなベンチマークです。187 のリポジトリから集めた 219 件の実際のプルリクエストで各レビュアーを実行し、レビュアーの報告内容を、人がレビューしてラベル付けした指摘事項と比較します。
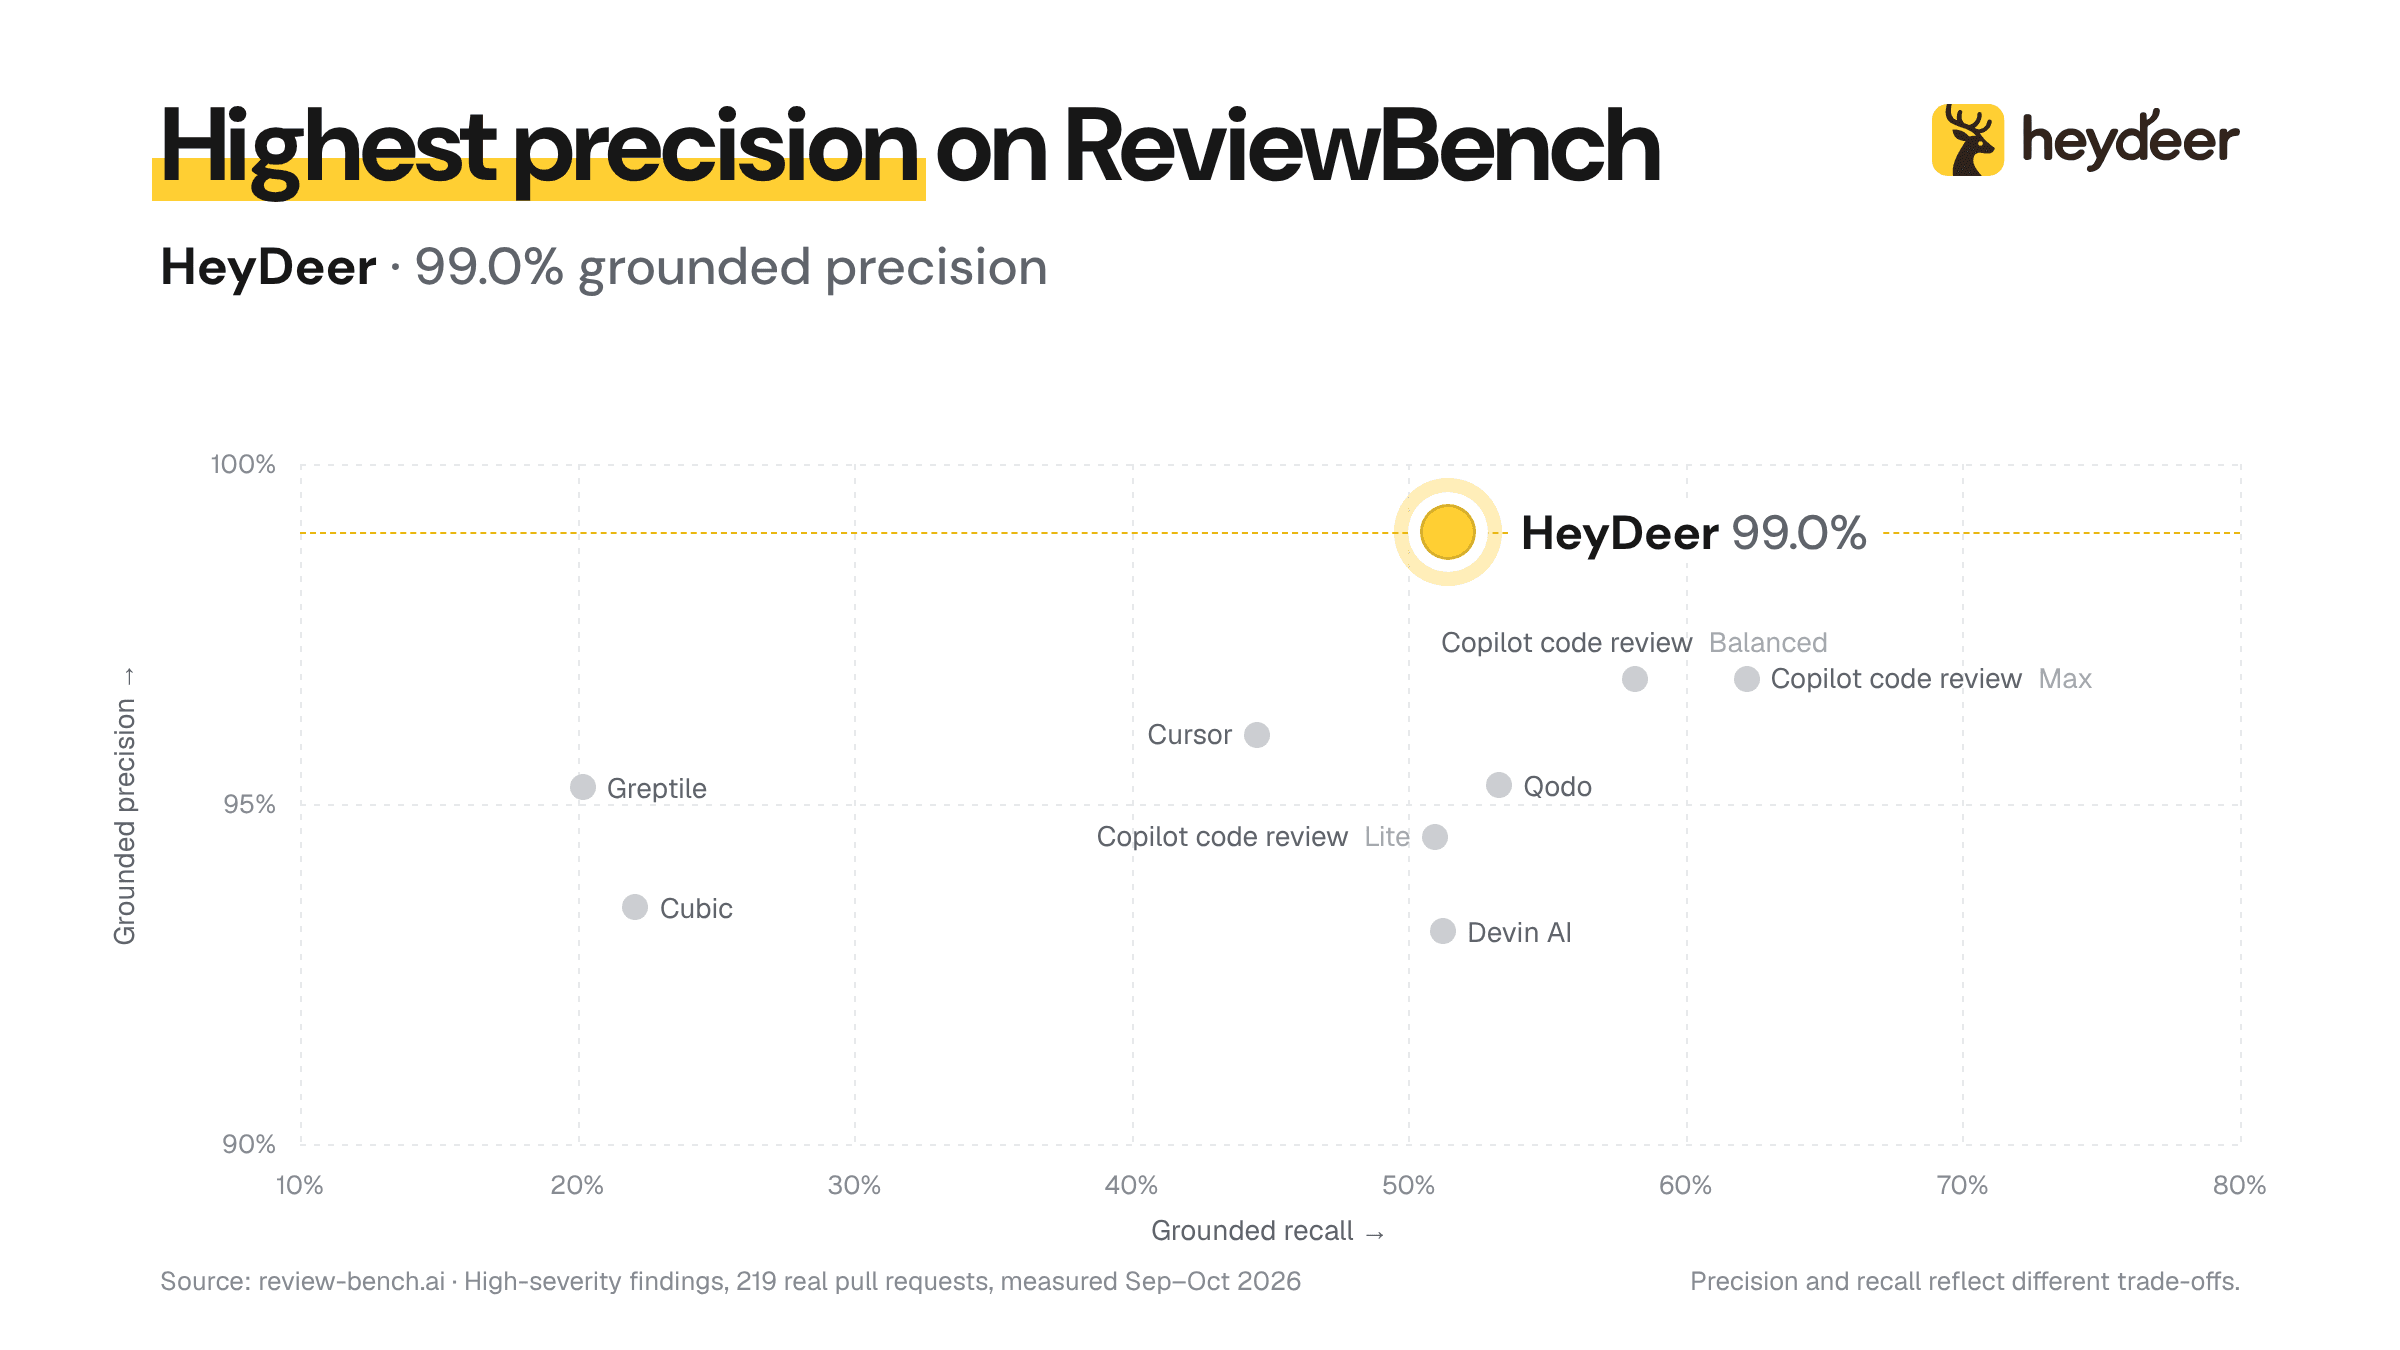
HeyDeer がリーダーボードに掲載されました。リーダーボードのデフォルト表示である高深刻度の指摘事項で、HeyDeer の適合率は掲載されているすべてのレビュアーの中で最も高い 99.0% でした。HeyDeer が報告した深刻な問題は、ほぼすべてが本物だったということです。
これは偶然ではありません。HeyDeer は最初から、適合率を第一の設計目標にしてきました。この記事では、その理由と、どうやって実現しているのかを説明します。
1. 数字が意味すること
ReviewBench は主に 2 つのスコアを報告しています(詳しくは評価方法を参照してください)。
- 適合率:レビュアーが報告し、ベンチマークで判定できる問題のうち、本物の問題の割合。
- 再現率:プルリクエスト内の既知の問題のうち、レビュアーが見つけた割合。
この 2 つはトレードオフの関係にあります。何でも報告するレビュアーは、見つける問題も増えますがノイズも増えます。ほとんど何も報告しないレビュアーは、めったに間違えませんが、役に立つこともめったにありません。ReviewBench が公開した実行結果では、高深刻度の指摘事項における HeyDeer の再現率は 51.4% で、掲載されている多くのレビュアーと同程度でしたが、適合率は最も高い値でした。
2. 適合率が重要な理由
人にとって:ノイズが本当のバグを覆い隠す
誤検知があるたびに、人の時間が奪われます。コメントを読み、コードを確認し、間違いだと判断するまでの時間です。もっと大きなコストは後からやってきます。ノイズが何度か続くと、人はそのレビュアーのコメントはたいてい間違っていると覚え、流し読みするようになります。そして本当のバグがひとつ、ほかのコメントと一緒に見過ごされてしまうのです。
8 件のコメントのうち 6 件が誤りのレビューは、本物の指摘が 3 件だけのレビューより劣ります。レビュアーが役に立つのは、人がその言葉を読み続けてくれる場合だけです。
コーディングエージェントにとって:誤検知がコードになる
レビューコメントをそのままコーディングエージェントに渡すチームが増えています。エージェントが反論することもありますが、修正依頼が誤りだと気づいた後でもそれに従い、気づかないうちに新たなエラーを持ち込むことが多いと研究で示されています(Jaiswal et al., 2026)。誤検知は、null になりえない値への null チェックや、例外を投げえないコードを囲む try/catch、すでに検証済みの入力に対する検証になります。
ひとつひとつは無害に見えます。しかし積み重なるとコードベースを肥大化させ、コードが本当に保証していることを見えにくくし、次の人や次のエージェントが読んで保守するものを増やします。レビューを自動化すればするほど、適合率は重要になります。ノイズをふるい落とす人がもういないからです。
3. HeyDeer が適合率を高く保つ方法
複数のモデルが相互にレビューし、検証し合う
単一のモデルは問題を見落とし、誤った指摘もします。同じモデルを複数並べても、同じ間違いを犯しがちです。HeyDeer は異なるベンダーのモデルに各変更をレビューさせ、潜在的な問題をひとつずつ独立して検証してから、プルリクエストに投稿します。モデルごとに死角が異なるため、相互に検証することで、どれかひとつのモデルが間違えた部分の多くを捉えられます。
ただし、意見の一致だけでは証明になりません。2 つのモデルが同じように間違えることもあるからです。指摘事項を投稿するかどうかを決めるのは、根拠です。
すべての指摘事項に根拠が必要
指摘事項は、問題がどのように起きるかを示さなければなりません。実際の呼び出し元、ユーザー操作、入力から始まり、変更されたコードを通って、どんな結果に至るのかです。「ここは null かもしれない」では不十分で、レビュアーは null がどこから来るのかを示す必要があります。手元の根拠では確定できない事実がある場合、指摘事項はそのことを明記してその事実を挙げ、推測を確かなことのように示したりはしません。
推測せず、ソースを読む
誤検知の多くは、差分の外にあるものの振る舞いを推測することから生まれます。HeyDeer のレビュアーは推測せずに確かめます。
- 依存関係のソース:ライブラリの振る舞いに左右される主張では、レビュアーは記憶に頼らず、そのライブラリの実際の実装を読みます。
- ドキュメント:レビュアーは、コードが使っているフレームワークやサービスの公式ドキュメントを検索します。
- サンドボックスでの検証:読むだけでは足りないとき、レビュアーは隔離されたサンドボックスで、ある関数がエッジケースをどう扱うかといった限定的な主張を試せます。リポジトリ自体のコードが実行されることはありません。
4. 再現率:ノイズを増やさずに、より多く見つける
黙っていれば、高い適合率は簡単に得られます。だからこそ再現率も同じくらい重要です。ReviewBench が測定したバージョン以降、私たちは HeyDeer の再現率を改善しており、ReviewBench が新しい実行結果を公開したら数値を共有します。
考え方は、見つけることとふるい分けることを分けることです。問題を探すレビュアーは、根拠で裏付けられる候補を、小さく見えても起こりそうになくても、すべて報告します。何が本物かは、その後の検証が判断します。検証が適合率を守るので、問題を探す段階ではより深く、より多くの角度から探しても、プルリクエストに届くノイズは増えません。
どこまで表示するかも選べます。HeyDeer のフィードバックの範囲を使えば、ワークスペース全体または個々のリポジトリごとに、重要な指摘事項だけを表示するか、確認済みの指摘事項をすべて表示するかをチームで選べます。
5. ベンチマークについて
すべてを語れるベンチマークはありません。ReviewBench はリサーチプレビューです。上の数値はデフォルトの高深刻度ビューのもので、深刻度のフィルターを変えれば変わります。また、ひとつのスコアだけでは、レビュアーがあなたのコードベースやチームに合うかどうかはわかりません。それでも、実際のプルリクエストでレビュアーを比較できる公正でオープンな方法だと考えていますし、公開の場で評価されることを歓迎しています。
自分のプルリクエストで試してみる
最良のベンチマークは、あなた自身のコードです。HeyDeer には無料プランがあります。いま使っているレビュアーと同じプルリクエストで HeyDeer を実行し、結果をご自身で比べてみてください。