
HeyDeer erreicht die höchste Präzision auf ReviewBench
Warum für uns Präzision an erster Stelle steht und wie HeyDeer sie erreicht
HeyDeer-Team ·
ReviewBench ist ein offener Benchmark für KI-Codeprüfung, entwickelt von GitHub. Er lässt jeden Prüfer 219 echte Pull Requests aus 187 Repositorys prüfen und vergleicht, was der Prüfer meldet, mit Befunden, die Menschen geprüft und eingeordnet haben.
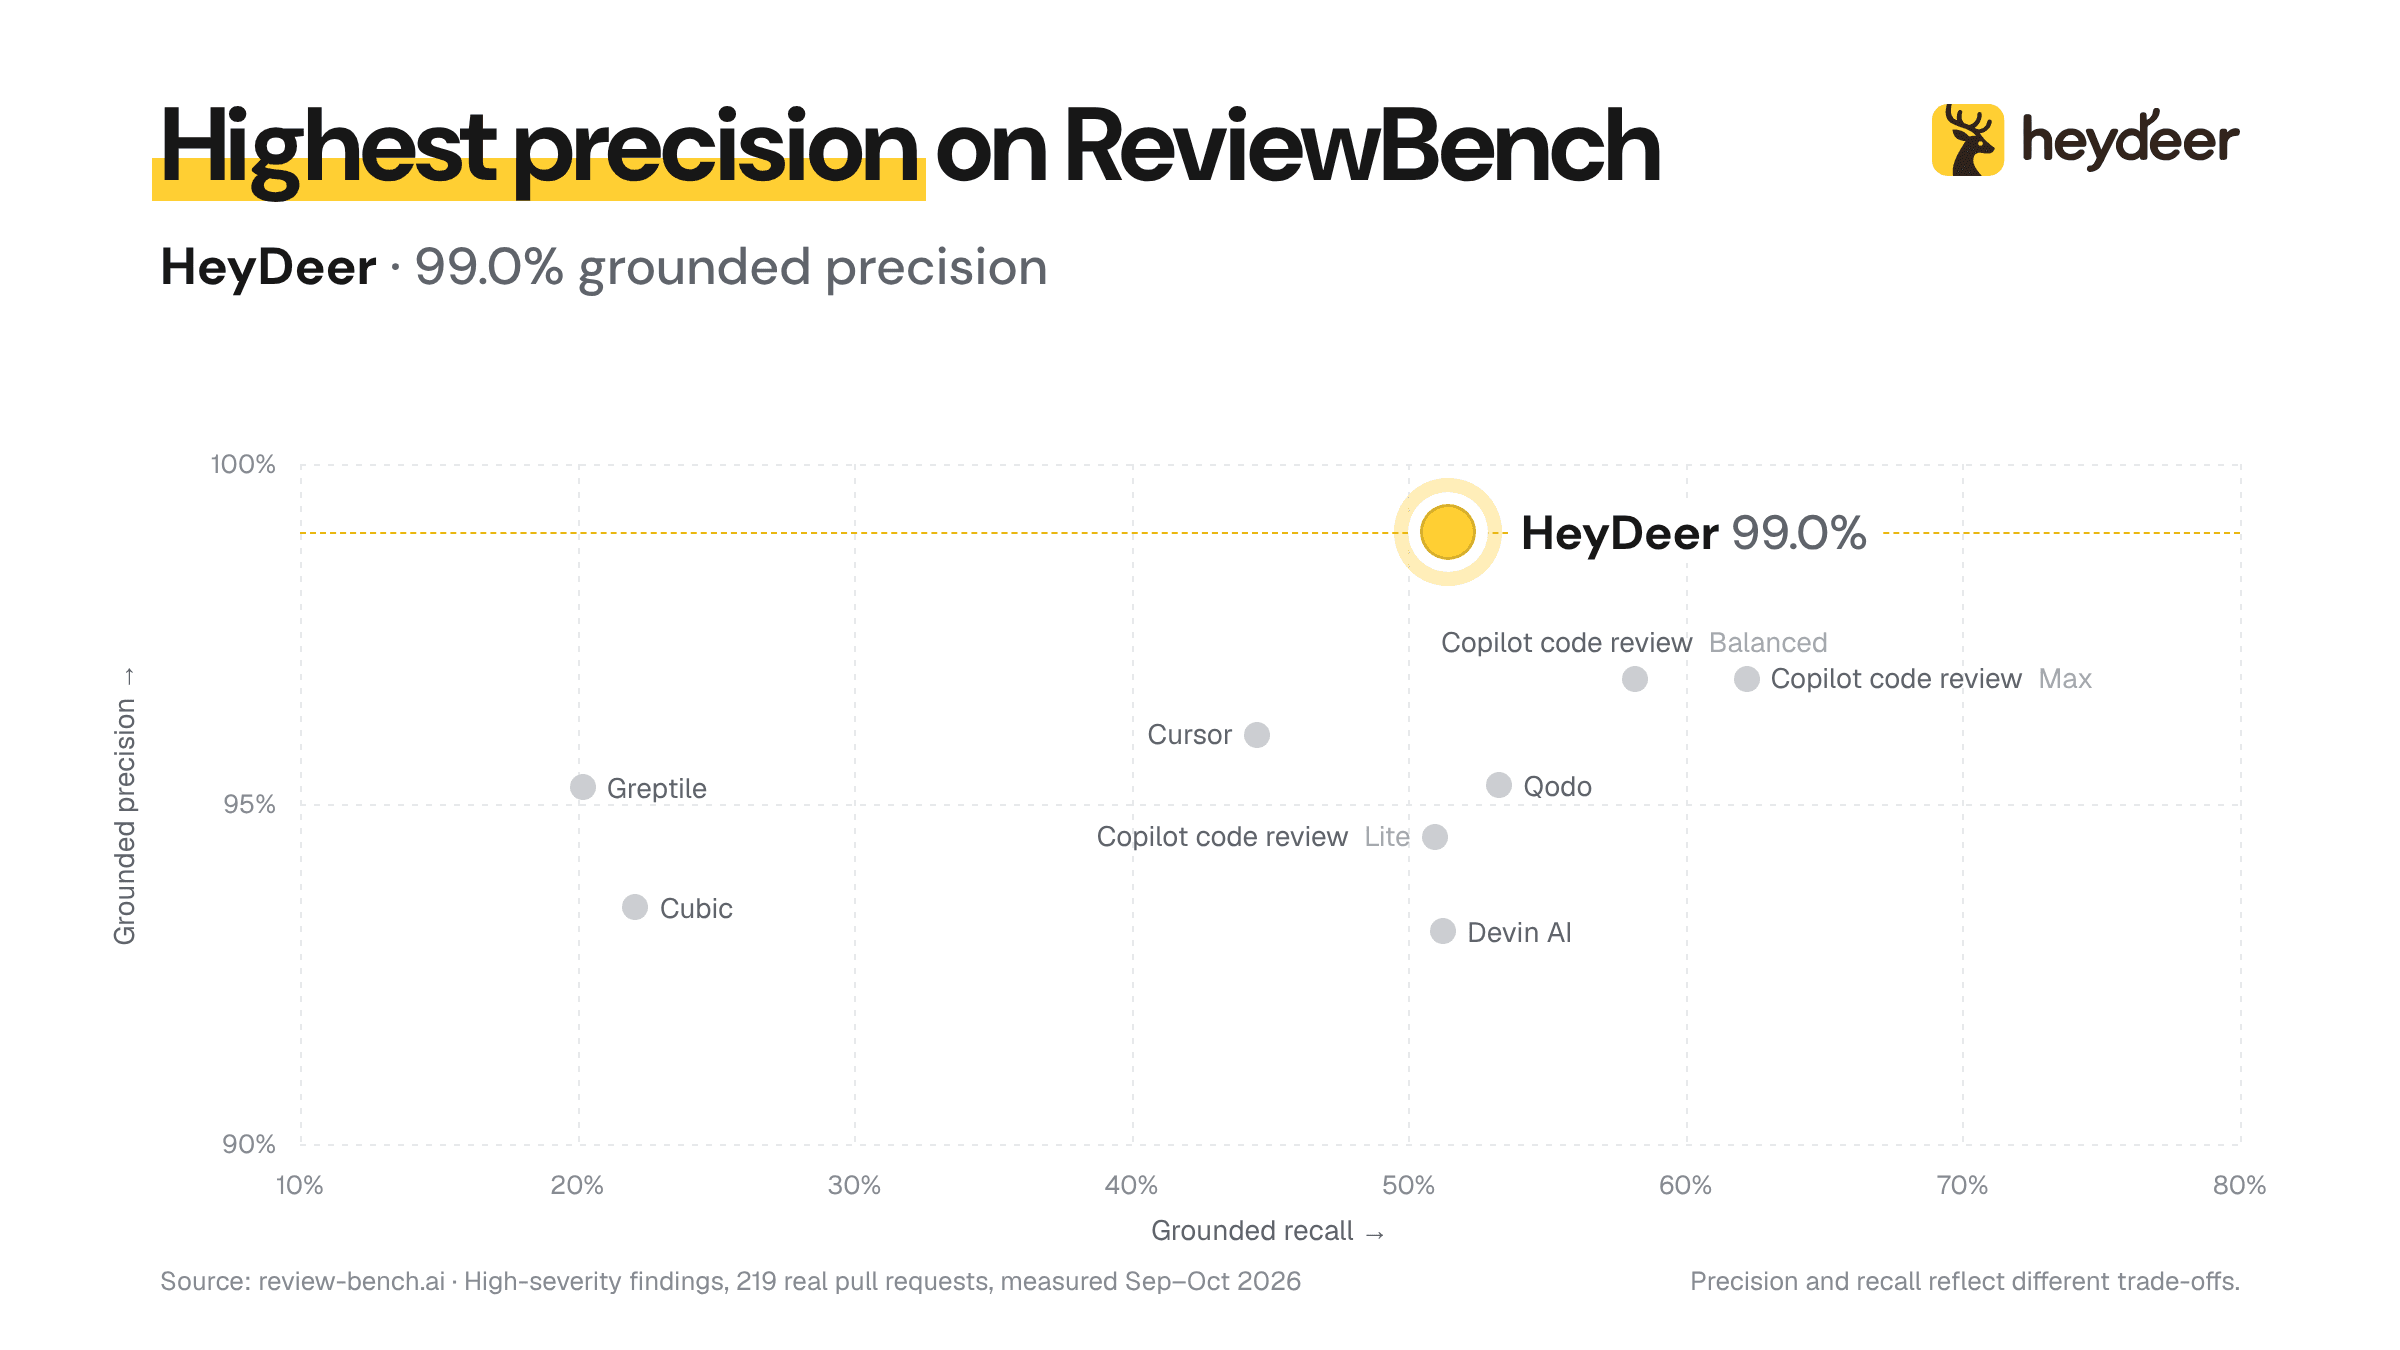
Jetzt steht auch HeyDeer auf der Rangliste. Bei Befunden mit hohem Schweregrad, der Standardansicht der Rangliste, hat HeyDeer die höchste Präzision aller Prüfer: 99,0 %. Fast jedes schwerwiegende Problem, das HeyDeer gemeldet hat, war echt.
Das ist kein Zufall. Präzision ist seit dem ersten Tag das wichtigste Designziel von HeyDeer. In diesem Beitrag erklären wir, warum, und wie wir sie erreichen.
1. Was die Zahlen bedeuten
ReviewBench misst zwei Hauptwerte (Details findest du in der Methodik):
- Präzision: Wie viele der Probleme, die ein Prüfer meldet und die der Benchmark beurteilen kann, echt sind.
- Recall (Trefferquote): Wie viele der bekannten Probleme in einem Pull Request der Prüfer findet.
Die beiden Werte ziehen in entgegengesetzte Richtungen. Ein Prüfer, der alles meldet, findet mehr Probleme, erzeugt aber auch mehr Rauschen; einer, der fast nichts meldet, liegt selten falsch und ist selten nützlich. In dem Durchlauf, den ReviewBench veröffentlicht hat, lag HeyDeers Recall bei Befunden mit hohem Schweregrad bei 51,4 % und damit im selben Bereich wie bei den meisten Prüfern auf der Rangliste, während seine Präzision die höchste war.
2. Warum Präzision wichtig ist
Für Menschen: Rauschen verdeckt die echten Bugs
Jeder Fehlalarm kostet einen Menschen Zeit: den Kommentar lesen, den Code ansehen und feststellen, dass der Kommentar nicht stimmt. Der größere Schaden kommt später. Nach ein paar Runden Rauschen lernen Menschen, dass die Kommentare des Prüfers meist falsch sind, und fangen an, sie nur noch zu überfliegen – und der eine echte Bug rutscht mit dem Rest durch.
Eine Prüfung mit acht Kommentaren, von denen sechs falsch sind, ist schlechter als eine mit drei echten. Ein Prüfer ist nur nützlich, solange Menschen noch lesen, was er schreibt.
Für Coding-Agenten: Fehlalarme werden zu Code
Immer mehr Teams geben Prüfkommentare direkt an einen Coding-Agenten weiter. Agenten widersprechen zwar manchmal, doch Untersuchungen zeigen, dass sie einer Änderungsanfrage oft folgen, obwohl sie sie als falsch erkannt haben, und dabei unbemerkt neue Fehler einbauen (Jaiswal et al., 2026). Aus einem Fehlalarm wird ein Null-Check für einen Wert, der nicht null sein kann, ein try/catch um Code, der keine Exception werfen kann, oder eine Validierung für Eingaben, die bereits validiert sind.
Jede dieser Änderungen wirkt für sich harmlos. Zusammen blähen sie die Codebasis auf, verschleiern, was der Code wirklich garantiert, und geben der nächsten Person oder dem nächsten Agenten mehr zu lesen und zu warten. Je mehr du von deiner Prüfung automatisierst, desto wichtiger wird Präzision, denn dann filtert niemand mehr das Rauschen heraus.
3. Wie HeyDeer die Präzision hoch hält
Mehrere Modelle prüfen und kontrollieren sich gegenseitig
Ein einzelnes Modell übersieht Probleme und meldet falsche, und mehrere Instanzen desselben Modells machen meist dieselben Fehler. Bei HeyDeer prüfen Modelle verschiedener Anbieter jede Änderung, und jedes mögliche Problem wird unabhängig verifiziert, bevor es in deinem Pull Request landet. Unterschiedliche Modelle haben unterschiedliche blinde Flecken, deshalb fängt der Abgleich vieles von dem ab, was ein einzelnes Modell falsch macht.
Übereinstimmung allein ist kein Beweis: Zwei Modelle können sich auf dieselbe Weise irren. Ob ein Befund veröffentlicht wird, entscheiden die Belege.
Jeder Befund braucht Belege
Ein Befund muss zeigen, wie das Problem entsteht: von einem echten Aufrufer, einer Nutzeraktion oder einer Eingabe über den geänderten Code bis zur Auswirkung. „Das könnte null sein“ reicht nicht; der Prüfer muss zeigen, woher das null kommt. Lässt sich eine Tatsache mit den verfügbaren Belegen nicht klären, sagt der Befund das und benennt diese Tatsache, statt eine Vermutung als sicher darzustellen.
Den Quellcode lesen statt raten
Viele Fehlalarme entstehen, weil geraten wird, wie sich etwas außerhalb des Diffs verhält. Die Prüfer von HeyDeer sehen stattdessen nach:
- Quellcode von Abhängigkeiten: Hängt eine Aussage davon ab, wie sich eine Bibliothek verhält, liest der Prüfer die tatsächliche Implementierung der Bibliothek, statt sich auf sein Gedächtnis zu verlassen.
- Dokumentation: Prüfer durchsuchen die offizielle Dokumentation der Frameworks und Dienste, die der Code verwendet.
- Tests in der Sandbox: Reicht Lesen nicht aus, kann ein Prüfer eine eng umrissene Aussage in einer isolierten Sandbox testen, etwa wie eine Funktion mit einem Grenzfall umgeht. Der Code deines Repositorys selbst wird nie ausgeführt.
4. Recall: mehr finden, ohne mehr Rauschen
Hohe Präzision ist leicht, wenn man still bleibt, deshalb ist Recall genauso wichtig. Seit der Version, die ReviewBench gemessen hat, haben wir den Recall von HeyDeer verbessert, und wir teilen die Zahlen, sobald ReviewBench einen neuen Durchlauf veröffentlicht.
Die Idee ist, Suchen und Filtern zu trennen. Die Prüfer, die nach Problemen suchen, melden jeden Kandidaten, den sie mit Belegen stützen können, auch wenn er klein oder unwahrscheinlich wirkt; die Verifizierung entscheidet dann, was echt ist. Weil die Verifizierung die Präzision sichert, kann die Suche gründlicher und aus mehr Blickwinkeln vorgehen, ohne mehr Rauschen in deinen Pull Request zu bringen.
Außerdem entscheidest du, wie viel du siehst. Mit dem Feedback-Umfang von HeyDeer kann ein Team für einen Arbeitsbereich oder ein einzelnes Repository festlegen, ob nur die wichtigen Befunde angezeigt werden oder alle bestätigten.
5. Über den Benchmark
Kein Benchmark erzählt die ganze Geschichte. ReviewBench ist eine Forschungsvorschau; die Zahlen oben stammen aus der Standardansicht für hohen Schweregrad und ändern sich mit dem Schweregradfilter; und ein einzelner Wert sagt nichts darüber, wie gut ein Prüfer zu deiner Codebasis oder deinem Team passt. Wir halten ReviewBench für einen fairen, offenen Weg, Prüfer an echten Pull Requests zu vergleichen, und freuen uns, öffentlich gemessen zu werden.
Probier es mit deinen eigenen Pull Requests aus
Der beste Benchmark ist dein eigener Code. HeyDeer hat einen kostenlosen Tarif, also kannst du es auf dieselben Pull Requests ansetzen wie den Prüfer, den du bereits nutzt, und die Ergebnisse selbst vergleichen.