
HeyDeer tiene la mayor precisión en ReviewBench
Por qué priorizamos la precisión y cómo la consigue HeyDeer
Equipo de HeyDeer ·
ReviewBench es un benchmark abierto de revisión de código con IA creado por GitHub. Pone a prueba a cada revisor con 219 pull requests reales de 187 repositorios y compara lo que señala el revisor con hallazgos que personas han revisado y etiquetado.
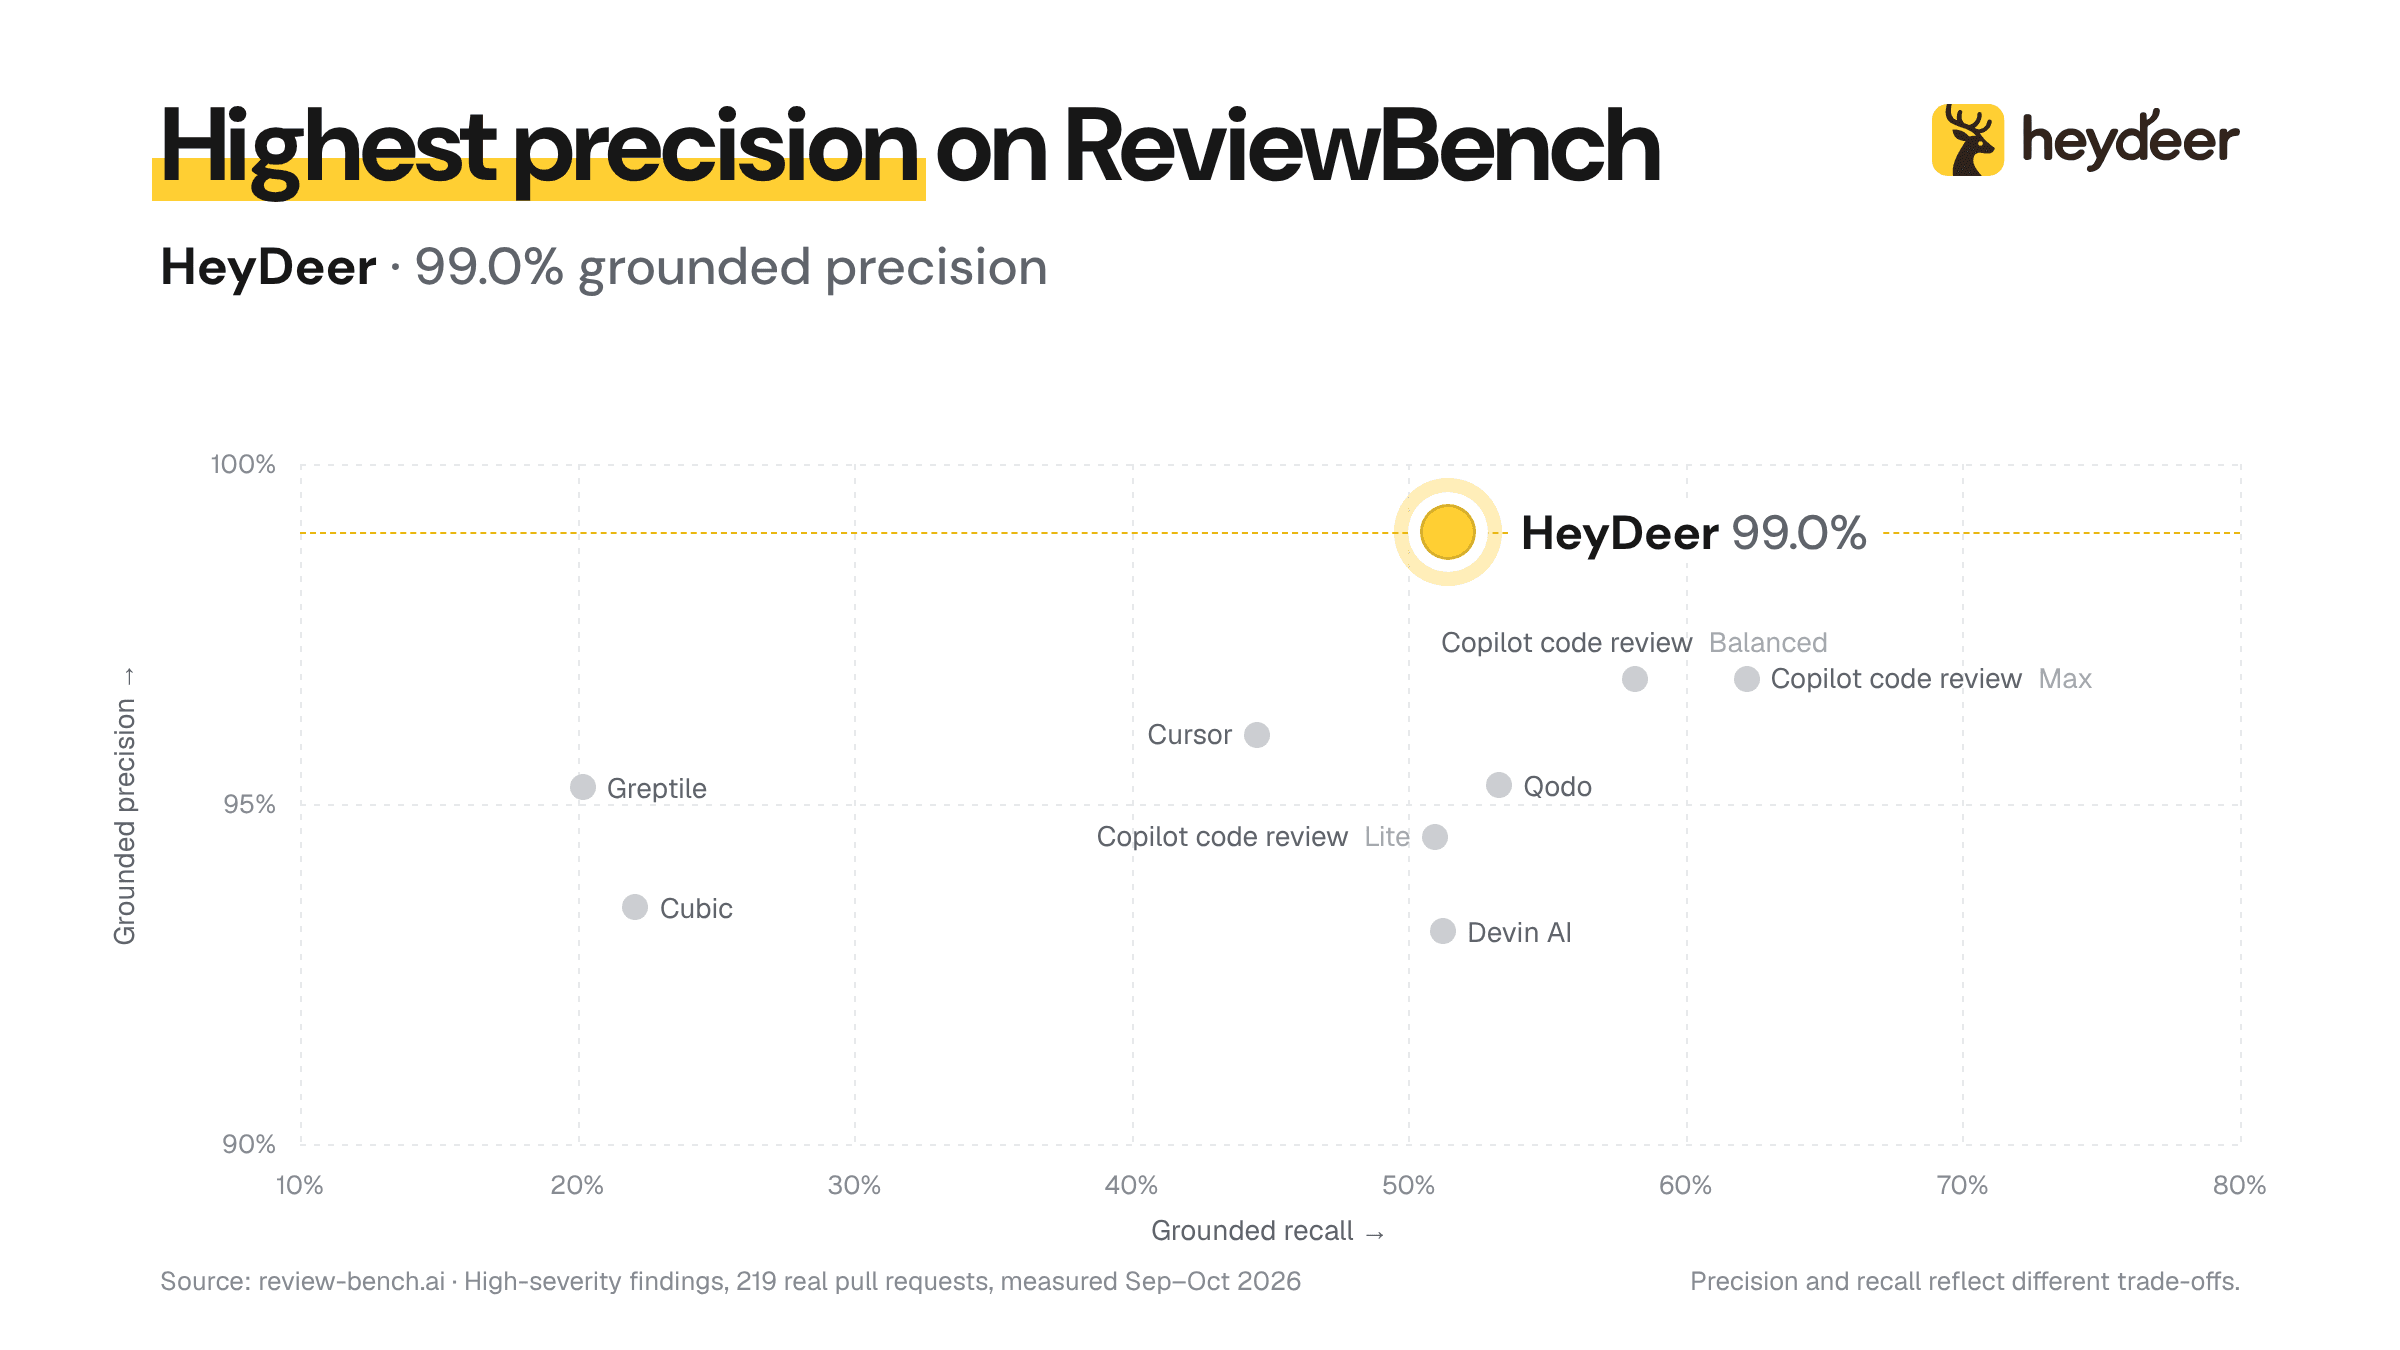
HeyDeer ya aparece en la clasificación. En los hallazgos de gravedad alta, la vista predeterminada de la clasificación, HeyDeer tiene la mayor precisión de todos los revisores: 99,0 %. Casi todos los problemas graves que señaló HeyDeer eran reales.
No es casualidad. La precisión ha sido el primer objetivo de diseño de HeyDeer desde el primer día. En este artículo explicamos por qué y cómo lo conseguimos.
1. Qué significan los números
ReviewBench da dos puntuaciones principales (consulta su metodología para más detalles):
- Precisión: de los problemas que señala un revisor y que el benchmark puede evaluar, cuántos son reales.
- Exhaustividad (recall): de los problemas conocidos de un pull request, cuántos encuentra el revisor.
Las dos tiran en sentidos opuestos. Un revisor que lo señala todo encuentra más problemas y también más ruido; uno que casi no señala nada rara vez se equivoca y rara vez resulta útil. En la ejecución que publicó ReviewBench, la exhaustividad de HeyDeer en hallazgos de gravedad alta fue del 51,4 %, en el mismo rango que la mayoría de los revisores de la clasificación, mientras que su precisión fue la más alta.
2. Por qué importa la precisión
Para las personas: el ruido esconde los bugs reales
Cada falso positivo le cuesta tiempo a una persona: leer el comentario, revisar el código y concluir que está mal. El coste mayor llega después. Tras unas cuantas rondas de ruido, la gente aprende que los comentarios del revisor suelen estar equivocados y empieza a leerlos por encima, y el único bug real se cuela con el resto.
Una revisión con ocho comentarios, seis de ellos falsos, es peor que una con tres comentarios reales. Un revisor solo es útil si la gente sigue leyendo lo que dice.
Para los agentes de programación: los falsos positivos se convierten en código
Cada vez más equipos pasan los comentarios de revisión directamente a un agente de programación. A veces un agente rebate, pero las investigaciones muestran que a menudo sigue una petición de corrección incluso después de reconocer que es errónea, e introduce sin darse cuenta errores nuevos (Jaiswal et al., 2026). Un falso positivo se convierte en una comprobación de null para un valor que no puede ser null, un try/catch alrededor de código que no puede lanzar excepciones o una validación de una entrada que ya está validada.
Cada uno parece inofensivo por separado. Juntos inflan la base de código, ocultan lo que el código garantiza de verdad y dan a la siguiente persona, o al siguiente agente, más que leer y mantener. Cuanto más automatizas la revisión, más importa la precisión, porque ya no queda nadie que filtre el ruido.
3. Cómo mantiene HeyDeer una precisión alta
Varios modelos revisan y se verifican entre sí
Un solo modelo pasa por alto problemas y señala otros que no existen, y varias copias del mismo modelo tienden a cometer los mismos errores. HeyDeer hace que modelos de distintos proveedores revisen cada cambio y verifica cada posible problema de forma independiente antes de que llegue a tu pull request. Cada modelo tiene sus propios puntos ciegos, así que la verificación cruzada detecta buena parte de lo que cualquiera de ellos hace mal.
El acuerdo por sí solo no es una prueba: dos modelos pueden equivocarse de la misma forma. Lo que decide si se publica un hallazgo es la evidencia.
Cada hallazgo necesita evidencia
Un hallazgo tiene que mostrar cómo se produce el problema: desde una llamada, una acción del usuario o una entrada reales, pasando por el código modificado, hasta la consecuencia. “Esto podría ser null” no basta; el revisor tiene que mostrar de dónde viene el null. Cuando un hecho no se puede determinar con la evidencia disponible, el hallazgo lo dice y nombra ese hecho, en lugar de presentar una suposición como algo seguro.
Leer el código fuente, no adivinar
Muchos falsos positivos vienen de suponer cómo se comporta algo que está fuera del diff. Los revisores de HeyDeer lo comprueban en lugar de suponer:
- Código fuente de las dependencias: cuando una afirmación depende de cómo se comporta una biblioteca, el revisor lee la implementación real de la biblioteca en lugar de fiarse de lo que recuerda.
- Documentación: los revisores buscan en la documentación oficial de los frameworks y servicios que usa el código.
- Pruebas en un sandbox: cuando leer no basta, un revisor puede probar una afirmación concreta en un sandbox aislado, como la forma en que una función trata un caso límite. El código de tu repositorio nunca se ejecuta.
4. Exhaustividad: encontrar más sin añadir ruido
Tener una precisión alta es fácil si no dices nada, así que la exhaustividad importa igual. Desde la versión que midió ReviewBench, hemos mejorado la exhaustividad de HeyDeer, y compartiremos las cifras cuando ReviewBench publique una nueva ejecución.
La idea es mantener separadas la búsqueda y el filtrado. Los revisores que buscan problemas señalan todos los candidatos que pueden respaldar con evidencia, aunque parezcan pequeños o improbables; después, la verificación decide qué es real. Como la verificación sostiene la precisión, la búsqueda puede ir más a fondo y desde más ángulos sin enviar más ruido a tu pull request.
También decides cuánto ves. El alcance de los comentarios de HeyDeer permite a un equipo mostrar solo los hallazgos importantes o todos los confirmados, en un espacio de trabajo o en un solo repositorio.
5. Sobre el benchmark
Ningún benchmark cuenta toda la historia. ReviewBench es una versión preliminar de investigación; las cifras anteriores corresponden a su vista predeterminada de gravedad alta y cambian con el filtro de gravedad; y una sola puntuación no dice cómo encaja un revisor con tu base de código o con tu equipo. Creemos que es una forma justa y abierta de comparar revisores con pull requests reales, y nos alegra que nos midan en público.
Pruébalo en tus propios pull requests
El mejor benchmark es tu propio código. HeyDeer tiene un plan gratuito, así que puedes usarlo en los mismos pull requests que el revisor que ya utilizas y comparar tú mismo los resultados.